这次热点真正带来的变化,不只是又多了一个标签
围绕 OpenAI expands image provenance with C2PA, SynthID, and a public verification tool 的讨论,表面上看像是在谈某个新功能、某种新标识,真正更值得注意的是:图片溯源、元数据、检测模型和人工判断,正在被越来越多团队当成同一条工作流里的不同证据层。
这正是 如何识别 AI 生成图片 这个搜索问题背后的关键。绝大多数难题都不是“看一眼就知道真假”的演示样本,而是已经在社交平台扩散、被裁剪转发、画质受损、语境混乱的可疑图片。
先说结论
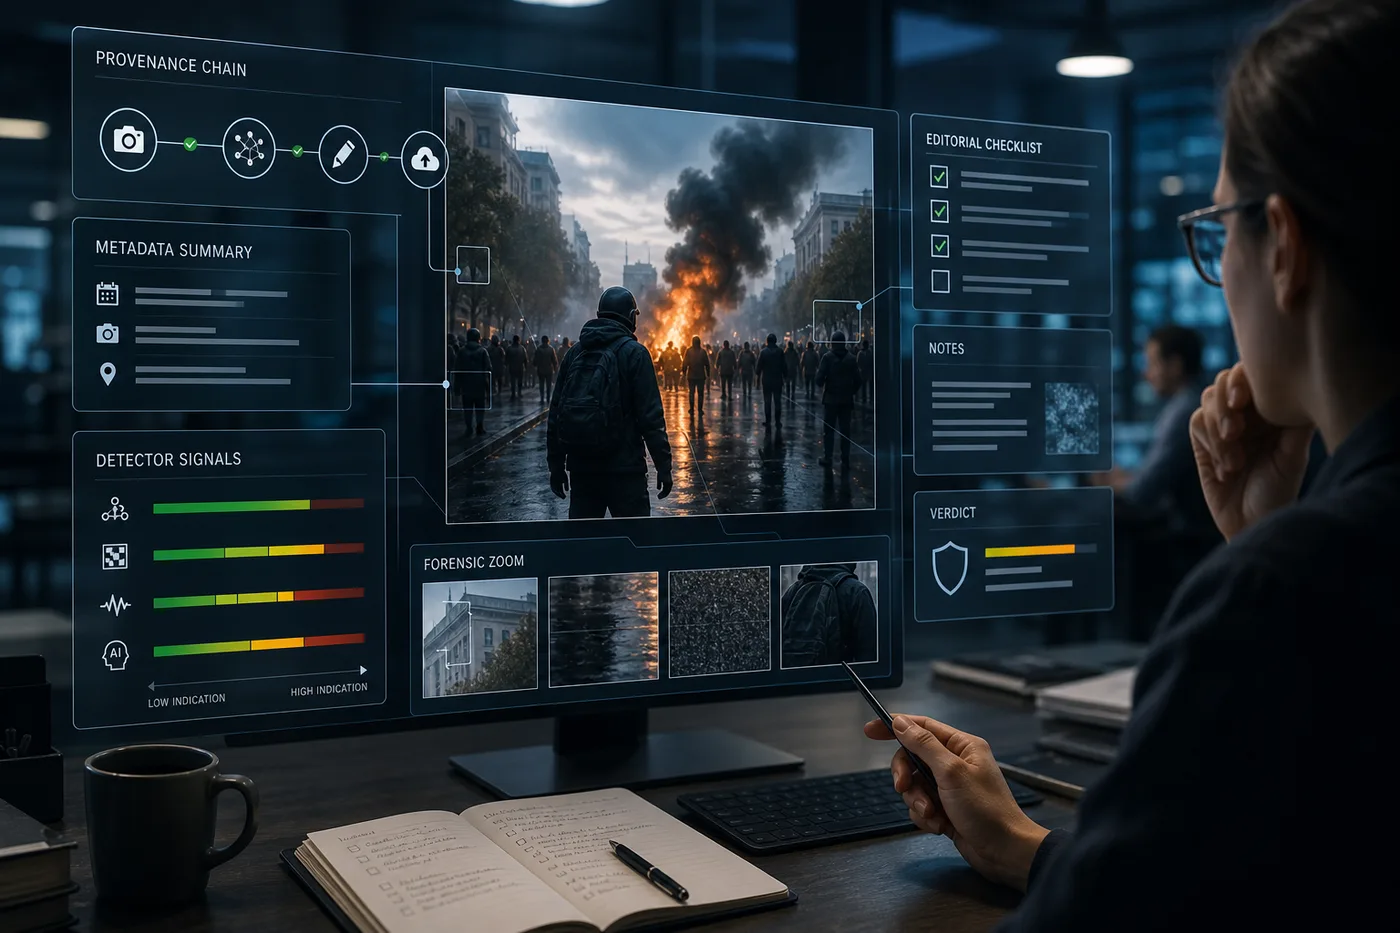
如果一张图已经在传播,不要问哪一个信号能单独“证明”答案,而要问:溯源能证明什么、元数据能证明什么、检测结果能提示什么、人工复核还能补什么。
新闻钩子
这篇文章对应的新闻钩子是 OpenAI expands image provenance with C2PA, SynthID, and a public verification tool,时间是 2026-05-19,来源为 OpenAI。原始链接可见:OpenAI。
一个真实的核查场景
更常见的情况是这样的:某张戏剧性很强的图片突然在 X、Telegram、微信群或新闻评论区里扩散,配文说它记录了某个突发事件。编辑、运营或审核团队需要尽快判断这张图值不值得引用、转发、报道,或者至少要不要加免责声明。
这时候最容易犯的错,就是谁先看到一个信号,就把那个信号当成最终结论。有人看到 detector 分数偏高,就直接说是 AI 图;有人看不出明显伪影,就误以为图片可信;还有人下载到的是二次压缩的 JPEG,元数据早就丢了,却还期待从 EXIF 里得到完整答案。
四类信号分别能证明什么
provenance / C2PA最有价值的前提,是证据链没有在转发过程中被剥离。EXIF / 编辑痕迹更适合帮助你重建文件经历了什么,而不是单独裁决真伪。detector 分数更适合做分流和优先级判断,不适合被包装成绝对结论。人工视觉与语境核查在技术信号不完整、互相冲突时反而最关键。
如果把项目结果放进文章,应该怎么写
如果这篇文章暂时没有可安全使用的项目截图,就不要硬塞图片。可以直接说明:真实核查仍然需要把溯源、元数据、模型输出和人工判断结合起来看。
对团队真正有用的,不是“神判定”,而是可复盘
对 新闻编辑与记者团队 来说,最重要的不是找到一个百分之百正确的按钮,而是留下一条能复盘的核查记录:检查了什么、缺失了什么、哪里仍然有不确定性、最终为什么选择发布、搁置、标注风险或继续升级人工复核。
继续阅读可参考 方法论、样例报告,或者直接去 免费开始检测。
如果你暂时不想马上使用工具,也可以先 先看方法论和样例报告。
常见问题
什么时候应该升级到人工复核?
当自动结果与人工观察冲突,或图像来源无法确认时,应升级到人工复核,并把结论标记为存疑而不是通过。
只看一个检测分数够不够?
不够。单个检测分数只是概率线索:压缩、截屏、编辑历史和元数据缺失都会改变它的输出,误报和漏报都真实存在,因此它只能用来决定先看哪一张,不能单独作为结论。
这类核查最容易忽略哪一步?
最常见的是跳过采集条件:同一张图在不同压缩、截屏、转发链路上会丢失不同证据,先确认文件是怎么来的,再判断画面本身。
四类证据分别能证明什么
| 证据类型 | 能回答什么 | 不能回答什么 |
|---|---|---|
| 来源与采集链路 | 文件从哪里来、经过哪些转手 | 画面本身是否真实 |
| C2PA 等来源凭证 | 是否由声明的主体生成或拍摄,以及之后是否被改过 | 没有凭证不等于伪造(大量正常图片根本没有签名) |
| EXIF 等元数据 | 拍摄设备、时间、是否经过编辑软件 | 元数据可被删除或伪造,缺失也无法定罪 |
| 检测模型分数 | 这张图与训练数据里的生成样本有多像,用来排优先级 | 不能单独作为结论,误报和漏报都真实存在 |